Prepara tu GPU para IA Local: NVIDIA Toolkit y Docker en Ubuntu 26.04
Instala controladores propietarios y NVIDIA Container Toolkit en Ubuntu 26.04 LTS para habilitar aceleración por GPU dentro de tus contenedores Docker.
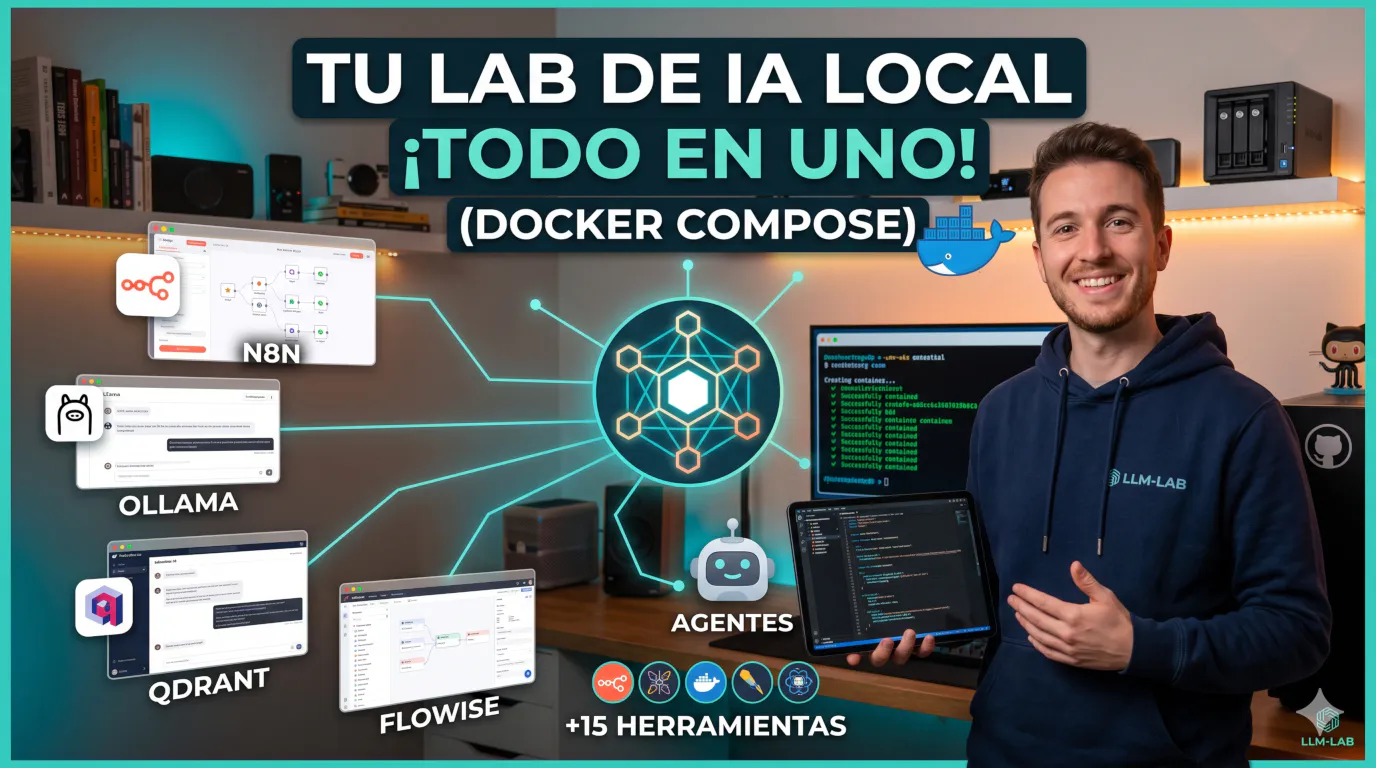
Video técnico en YouTube: Crea tu propio Laboratorio de Inteligencia Artificial Local con un solo comando
Enviar documentos internos, contratos, código fuente o bitácoras de red hacia APIs públicas de modelos de lenguaje implica costos recurrentes por token y riesgos directos de privacidad o cumplimiento corporativo. Muchas organizaciones necesitan experimentar con modelos abiertos (open weights), construir flujos de Generación Aumentada por Recuperación (RAG) y conectar agentes autónomos manteniendo el 100 % de los datos dentro de su propia red.
Nuestro proyecto abierto LLM-Lab empaqueta en un despliegue reproducible con Docker Compose todo el ecosistema necesario —Ollama, Open WebUI, n8n y Hermes Agent— para levantar un laboratorio privado en minutos sin instalar dependencias en tu sistema anfitrión.
llm-lab y levantar el stack en un pasoDescarga el repositorio oficial y despliega la pila completa con un único comando de arranque:
git clone https://github.com/tecno-consultores/llm-lab.git && cd llm-lab && docker compose up -dSi prefieres inspeccionar primero la estructura básica de servicios entre Ollama y Open WebUI, la arquitectura de referencia en compose.yaml separa almacenamiento persistente e intercomunicación interna de esta manera:
services:
  ollama:
    image: ollama/ollama:latest
    container_name: llm-ollama
    restart: unless-stopped
    volumes:
      - ollama_models:/root/.ollama
    networks:
      - llm-net

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: llm-open-webui
    restart: unless-stopped
    ports:
      - "127.0.0.1:3000:8080"
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
    volumes:
      - openwebui_data:/app/backend/data
    depends_on:
      - ollama
    networks:
      - llm-net

volumes:
  ollama_models:
  openwebui_data:

networks:
  llm-net:
driver: bridgeUna vez levantados los contenedores, descarga un modelo compacto y eficiente para pruebas de conversación o programación:
docker exec -it llm-ollama ollama pull llama3.1:8bComprueba la lista de modelos cargados dentro del contenedor y verifica que la interfaz web responda localmente en el puerto 3000:
docker exec llm-ollama ollama list
curl -I http://127.0.0.1:3000
Al abrir http://localhost:3000 podrás registrar tu cuenta administradora inicial en Open WebUI y comenzar a consultar modelos locales o adjuntar documentos en colecciones RAG sin tráfico saliente hacia proveedores externos.
11434 de Ollama hacia Internet: La API de Ollama no incorpora autenticación nativa por defecto; mantenla accesible únicamente dentro de la red interna de Docker o detrás de un proxy autenticado.openwebui_data y credenciales cifradas de n8n) en tu rutina de respaldo corporativo 3-2-1.Si deseas llevar un laboratorio privado de Inteligencia Artificial y RAG a producción empresarial, ofrecemos consultoría para el diseño, la implementación, el despliegue y el mantenimiento continuo de plataformas LLM desde Valencia, Estado Carabobo (Contáctanos).
Instala controladores propietarios y NVIDIA Container Toolkit en Ubuntu 26.04 LTS para habilitar aceleración por GPU dentro de tus contenedores Docker.
Despliega EvolutionAPI con Docker Compose, PostgreSQL y Redis para integrar mensajería automatizada de WhatsApp con flujos n8n y agentes conversacionales.
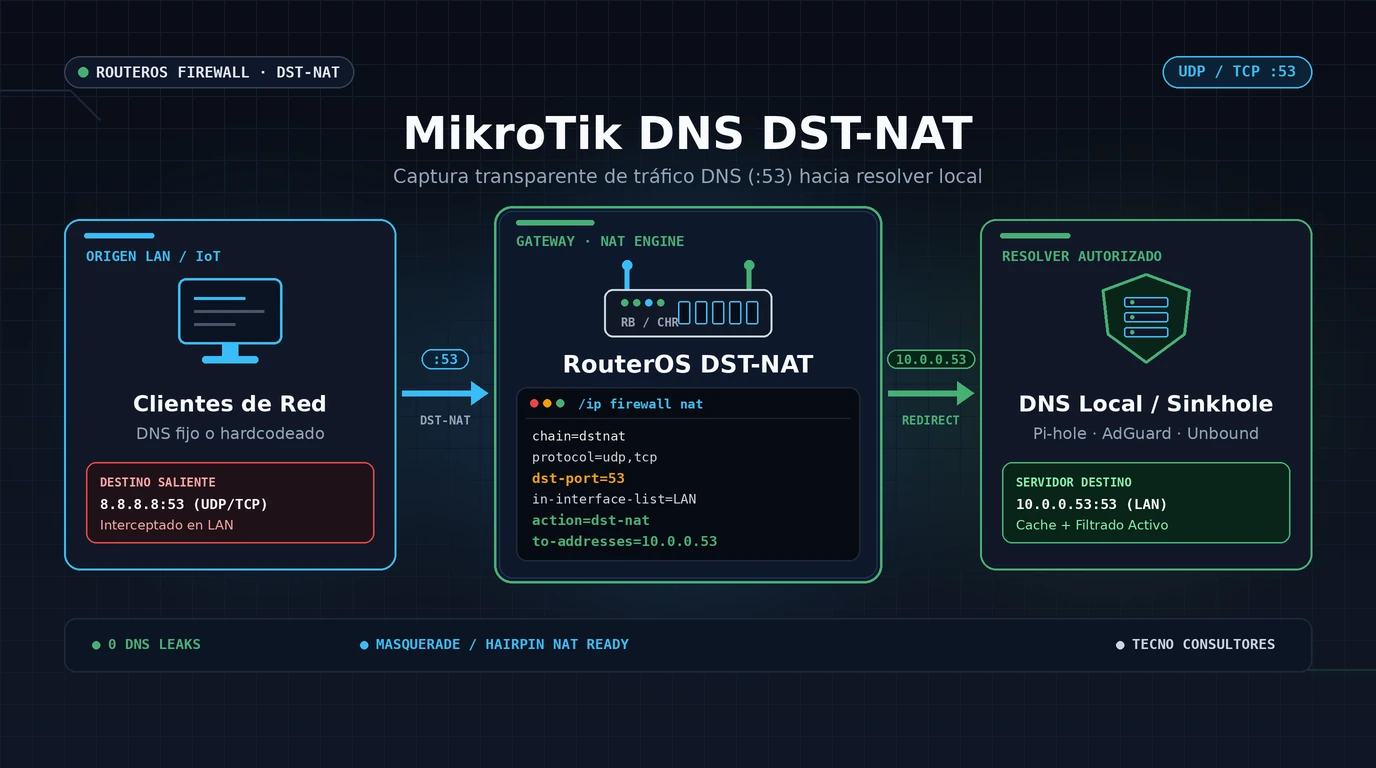
Redirige de forma transparente el tráfico DNS rebelde (puerto 53 TCP/UDP) mediante reglas DST-NAT en MikroTik RouterOS v7 hacia tu servidor DNS local.